NOTES · ÉCHELLE
Plusieurs salles, une seule réponse : comment True Causes passe à l’échelle
True Causes met en œuvre le Dialogue démocratique structuré (Structured Democratic Dialogue) en ligne. Un amphithéâtre accueille deux cents personnes ; Internet n’a pas d’amphithéâtre, et que quinze personnes délibèrent sur le web n’est pas le plus difficile : le Dialogue démocratique structuré le fait depuis des années. Le plus difficile, ce sont quarante salles de quinze personnes qui travaillent la même question et aboutissent à une seule réponse — puis quatre mille, sans que la charge de quiconque augmente. Cela demande quatre choses : savoir quand deux groupes ont dit la même chose, porter une affirmation soulevée par deux groupes vers les quelques groupes les plus à même de la juger, envoyer un blocage là où il peut être tranché, et fusionner chaque carte locale en une seule. Les travaux récents de la méthode elle-même s’approchent le plus du dernier point : des cartes individuelles asynchrones utilisées pour étendre la carte d’une session (Laouris, 2023), et des cartes thématiques fusionnées lors d’une session finale réunissant leurs auteurs (Michaelides & Laouris, 2024). Ce qui n’avait pas été construit, c’est de le faire pour des milliers de salles, sans session pour les fusionner. Ce à quoi cela revient, c’est une intelligence collective sans comité : personne ne détient la carte entière, et personne n’a à le faire.
Trois choses attachent un co-laboratoire à son lieu : tout le monde lit le même mur, un seul facilitateur tient tous les fils, et la salle décide de ce que veut dire une affirmation. Chacune a ici un équivalent qui n’a pas besoin de la salle. Un facilitateur est le bienvenu dans toute salle ; ce qui change, c’est que la méthode ne dépend plus de sa présence.
Chaque groupe a son propre mur
Les participants travaillent en petits groupes — assez petits pour que chacun lise tout le mur. Quand une salle dépasse cette taille, elle est répartie en groupes, chacun avec son propre mur, et la carte de la salle les contient tous. La charge de personne ne grandit avec la salle : le travail d’une personne est le même, que la question compte quinze participants ou deux millions.
La même question, où qu’elle soit posée
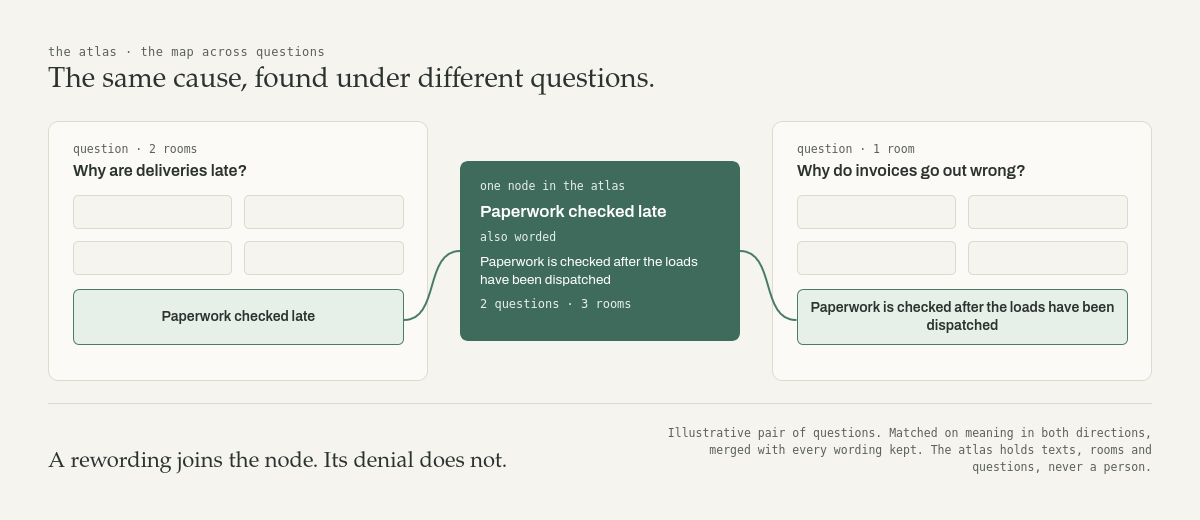
L’unité n’est pas la salle — c’est la question. Ouvrez un dialogue, et la plateforme reconnaît les autres salles qui la posent déjà, quelle qu’en soit la formulation, et les réunit en une seule délibération. Leurs groupes deviennent des groupes de la même question, et les affirmations circulent entre tous.
Quelques idées voyagent, les personnes non
La même affirmation écrite dans deux groupes compte comme une affirmation soulevée par deux groupes. C’est ce seul choix qui rend l’échelle calculable : sans lui, une affirmation présente dans quarante salles fait quarante éléments, et plus rien ne peut être compté. Entre les salles, quelques fiches voyagent — une fois qu’une salle a fini la Proposition et avant qu’elle commence la Clarification, pour que rien n’arrive pendant que les gens réfléchissent encore par eux-mêmes. Seules quelques-unes voyagent, choisies pour être diverses, pour qu’un mur reste un mur quel que soit le nombre de salles. Elles arrivent avec la clarification de leur auteur, comme des fiches ordinaires, et sont jugées comme toutes les autres. Une salle privée peut le demander à sens unique : les fiches des salles référencées sur sa question arrivent toujours sur ses murs, et rien d’elle ne sort.
Comment deux formulations deviennent une seule affirmation
Compter les groupes n’a de sens que si l’on sait reconnaître quand deux d’entre eux ont dit la même chose en d’autres mots. La plateforme repère les paires probables et les soumet aux personnes qui les ont écrites. Elle ne fusionne jamais rien elle-même : deux membres doivent convenir que deux formulations sont une seule affirmation, et chacun peut revenir sur cet accord.
L’asymétrie est délibérée. Une fausse fusion est l’erreur qui coûte cher — fondez une affirmation dans une affirmation populaire et elle hérite de son soutien — alors qu’une fusion manquée ne coûte qu’un peu d’efficacité, puisque l’affirmation voyage simplement comme deux éléments au lieu d’un. Des affirmations qui se contredisent ou s’inversent ne sont jamais proposées comme une même affirmation, si semblables qu’elles paraissent.
La carte de chaque groupe devient une seule carte
Chaque groupe structure le mur sur lequel il a réellement délibéré et produit sa propre carte. Ces cartes sont ensuite fusionnées : une même affirmation est un seul nœud, chaque lien indique combien de groupes l’ont certifié indépendamment, les boucles de rétroaction se réduisent à une seule cause profonde, et les causes profondes se lisent sur le graphe fusionné. Là où des groupes d’une même salle ont certifié des choses opposées, la contradiction est publiée comme un conflit et renvoyée, comme tout blocage, à deux autres groupes qui doivent être d’accord. D’une salle à l’autre, le constat de chaque salle tient, et le lien indique combien des salles qui l’ont jugé l’ont trouvé : une cause peut valoir à un endroit et pas à un autre. Rien n’est moyenné.
Une intelligence collective dans chaque salle, un essaim entre elles
Chaque salle est à elle seule une intelligence collective : des personnes qui clarifient, débattent et jugent ensemble. Sa pensée se répartit entre ses membres, son mur et sa carte : ce que les chercheurs appellent la cognition distribuée. Entre les salles, la plateforme ajoute un essaim. Dans les essaims que l’on connaît par la nature et par le logiciel, chaque membre suit la trace laissée par les autres : les fourmis renforcent le chemin que la plupart des fourmis ont pris, et dans un essaim humain en direct, chacun voit où tire le groupe. C’est ainsi qu’un essaim converge, et c’est aussi ainsi qu’une foule devient un troupeau. Ici, les salles ne se suivent pas. Une salle écrit avant que rien n’arrive, juge ses paires sans voir comment d’autres salles les ont jugées, et une organisation compte pour une seule voix, quel que soit le nombre de salles qu’elle ouvre. Quand beaucoup de salles certifient le même lien, elles l’ont donc trouvé chacune de son côté, et le chiffre veut dire quelque chose. Un accord ne vaut preuve que dans la mesure où les sources étaient indépendantes, ce que l’épistémologie sociale dit du témoignage. L’essaim est dans la structure : aucune salle ne tient le problème entier, les fiches qui voyagent sont peu nombreuses et choisies pour être diverses, et la carte qui en sort contient des liens qu’aucune salle seule n’aurait pu dessiner.
Pourquoi de petits groupes. En dessous d’une douzaine de personnes environ, un panel commence à perdre des causes ; au-delà de la taille qu’une personne peut lire comme un seul mur et suivre comme une seule conversation, il ne gagne rien — la taille que les praticiens de la méthode ont retenue au fil de cent vingt dialogues. L’échelle vient donc de groupes plus nombreux, pas de groupes plus grands.
Où va un blocage. Ni au groupe qui s’est divisé, ni à tout le monde. La question est renvoyée à deux autres groupes entiers, choisis d’une manière que personne ne peut orienter vers un public favorable. Chacun répond de son côté, et ils doivent être d’accord — sinon, la paire est publiée comme contestée. Un seul groupe ne suffit jamais : en simulation, un renvoi unique rend une mauvaise réponse dans 29.6% des cas quand un bloc vote, alors que deux renvois ou plus, non.
Ce qu’obtient un vote concerté. Trois des quinze places d’un groupe, un cinquième, qui votent ensemble contre une cause la maintiennent à 40% de là où elle devrait être, sans toucher à rien d’autre. Le renvoi à d’autres groupes la ramène à 62%. Le reste est comblé par les places réservées — une voie vers la liste restreinte qui ne passe pas par ceux qui tentent de l’en écarter. Empiler des voix sur le seul vote ne produit rien que les places réservées ne corrigent.
Aucun modèle ne décide de rien. Un modèle de langage n’est utilisé qu’à un seul endroit — pour décomposer en prémisses un argument écrit en langage courant, afin que la vérification logique puisse s’exécuter — et il lui est interdit de juger si l’argument est valide ; c’est un moteur fixe qui le fait. Décider que deux affirmations sont identiques est laissé aux personnes.
Le soutien doit se mériter. Un lien ne compte comme trouvé par plusieurs salles que si ces salles sont vraiment distinctes : des salles qui reposent sur une même source, ou votent comme une seule, comptent une fois. En simulation, cinq salles fabriquées face à cinq vraies ont fait sortir une vraie cause de la carte commune dans 31% des essais ; avec cette règle, la cause a tenu dans tous les essais.